Jokaisella laskulla on eri saaja, summa ja eräpäivä. Kun asiakirjoja kertyy kymmeniä tuhansia vuodessa, niiden metatiedottaminen käsin sitoo kuukausien työpanoksen. Profiumin Sähköisen Arkiston tekoälypohjainen metatietojen irrotus muuttaa asetelman.
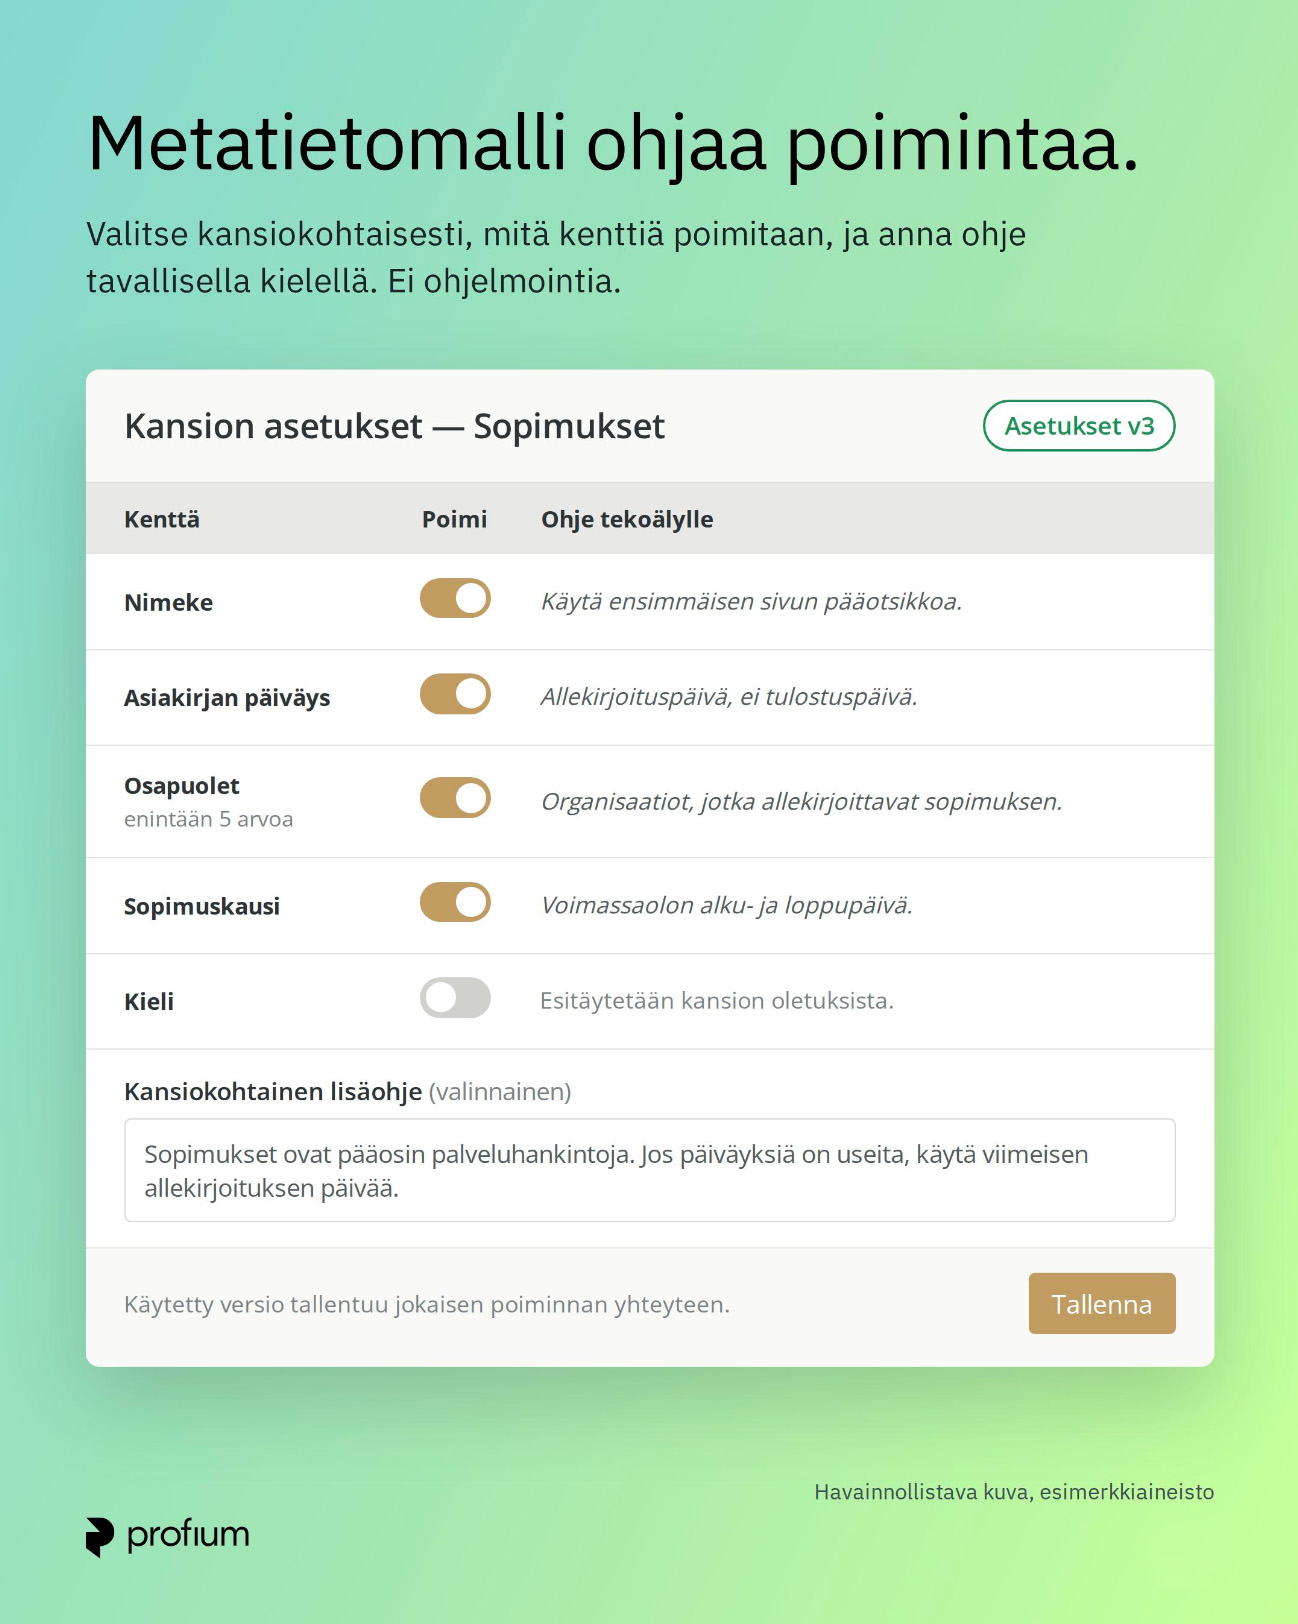
Metatiedot ovat asiakirjaa kuvaavia tietoja, joiden avulla asiakirja löytyy arkistosta ja sitä voidaan käsitellä oikein. Tekoälypohjaisessa irrotuksessa Sähköinen Arkisto lukee asiakirjan tekstisisällön, ja kielimalli etsii siitä ne tiedot, jotka käyttäjä on kullekin kentälle kuvannut. Jos kentän kuvaus on esimerkiksi ”laskun eräpäivä”, malli poimii asiakirjasta juuri sen päivämäärän ja tallentaa sen oikeaan kenttään oikeassa muodossa. Poimittavat tiedot voivat olla nimiä, päivämääriä, y-tunnuksia, tilinumeroita tai summia. Lopuksi ihminen hyväksyy ehdotetut arvot.
Arkistoissa kaikille asiakirjoille yhteiset tiedot on yleensä kuvailtu. Pullonkaula ovat asiakirjakohtaiset arvot, kuten laskun saaja ja summa tai tarjouspyynnön osapuolet, jotka on haettava jokaisesta tiedostosta erikseen. Kiireessä juuri tämä työ jää tekemättä, ja tieto on myöhemmin vaikea löytää.
Testattu suurten asiakirjamassojen keskellä
Käytännössä ominaisuutta on testattu suuren suomalaisen organisaation asiakirjoilla. Organisaatiossa syntyy kymmeniä tuhansia taloushallinnon ja hallinnon asiakirjoja vuodessa, ja tavoitteena on käsitellä tulevaisuudessa satoja tuhansia, jopa miljoonia asiakirjoja vuodessa.
Testiaineisto on kirjava. Laskut ovat lyhyitä ja taulukkomuotoisia, tarjouspyynnöt pitkiä ja tekstipainotteisia. Suurin osa asiakirjoista on suomeksi, mutta joukossa on myös englanninkielisiä. Kieli ei ole osoittautunut esteeksi: malli löytää arvot, vaikka kentän kuvaus olisi suomeksi ja asiakirja englanniksi.
Aikasäästö on merkittävä. Jos yhden asiakirjan kuvailu vie käsin kaksi minuuttia, 10 000 asiakirjaa tarkoittaa noin 330 työtuntia vuodessa, eli yli kahden kuukauden kokoaikaisen työntekijän panosta. Tekoälyn kanssa metatiedot haetaan erissä, ja ihmisen työ keskittyy tarkastamiseen. Asiakasorganisaatio on nähnyt toiminnosta demoja, on ollut tyytyväinen ja haluaa ottaa sen nopeasti käyttöön.
Kielimalli ei yksin riitä
Pelkkä tiedon poimiminen asiakirjasta ei ole enää suurin haaste. Vaikeampaa on se, mihin tulos tallennetaan ja miten se pysyy luotettavana ja haettavana vuosien ajan.
– Profiumilla on jo tuote, joka tukee metatietojen ja asiakirjojen välisiä suhteita, ja se on tehty nimenomaan julkishallinnon organisaatioille. Jos ulkopuolinen toimija lähtisi rakentamaan tätä niin, että myös tietomalli ja tiedon pitkäaikaissäilytys kuuluisivat projektiin, itse tekoälyosuus olisi vasta pieni osa kokonaisuutta, sanoo Sähköisen Arkiston tuotepäällikkö Toni Jutila.
Profiumin juuret semanttisessa tiedonhallinnassa tarkoittavat, että tekoälyn tuottama tieto asettuu suoraan valmiiseen, julkishallinnon vaatimuksiin suunniteltuun rakenteeseen.
Jäljitettävä ja hallittu
Jokainen tekoälyn irrottama kenttä merkitään, ja asiakirjaan tallentuu tieto tekoälyirrotuksesta.
– Ihminen on aina vastuussa hyväksynnästä, joten asiakirjan luoja on ihminen eikä tekoäly. Prosessi on dokumentoitu: siitä näkee, mitkä kentät tekoäly irrotti, Jutila kertoo.
Tarkastuksen laajuuden organisaatio päättää itse, ja luottamuksen kasvaessa kaikkien asiakirjojen läpikäynnistä voidaan siirtyä pistokokeisiin. Myöskään kielimalli ei ole lukittu: sen voi vaihtaa, ja se voi toimia pilvessä tai organisaation omassa ympäristössä. Tämä on olennaista, kun aineisto ei saa poistua omista järjestelmistä.
Kenelle?
Eniten automaattisesta metatiedon irrottamisesta hyötyy organisaatio, jolla on paljon aineistoa mutta vähän resursseja sen kuvailuun. Hyöty ei rajoitu säästettyyn aikaan, sillä metatiedotettu tieto on myös myöhemmin paremmin löydettävissä.
– Nyt kielimalli irrottaa metatiedot, mutta tulevaisuudessa juuri nuo metatiedot mahdollistavat kielimallien hyödyntämisen myös tiedon hakemisessa ja käytössä, Jutila sanoo.
Haluatko nähdä, miten tekoälypohjainen metatietojen irrotus toimisi teidän aineistollanne? Ota yhteyttä ja sovitaan demo.